
通过稳定 ID 对比两次输出,区分标签变化、缺失和新增,不凭「看起来更好」决定上线。按公开来源整理,非本站实测;判断≠自动执行。
来源 · JevLog 原创 · 本站原创
2026-09-21 · 编辑整理,未调用真实模型
背景 / 问题
Section titled “背景 / 问题”新规则运行后标签更整齐,不代表比旧规则更正确。你首先需要一个变化清单:哪些原始记录变了标签,哪些没了,哪些本来不在上一批数据里。
这篇的脚本不调用模型,只比较两份输出。没有人工参考答案时,它不会给你一个虚构准确率。配套演示实际运行了随包 before/after 合成样本。
- 两份 CSV 各有唯一且非空的 id,以及 label 列。
- 初次使用 examples/before.csv 与 examples/after.csv。
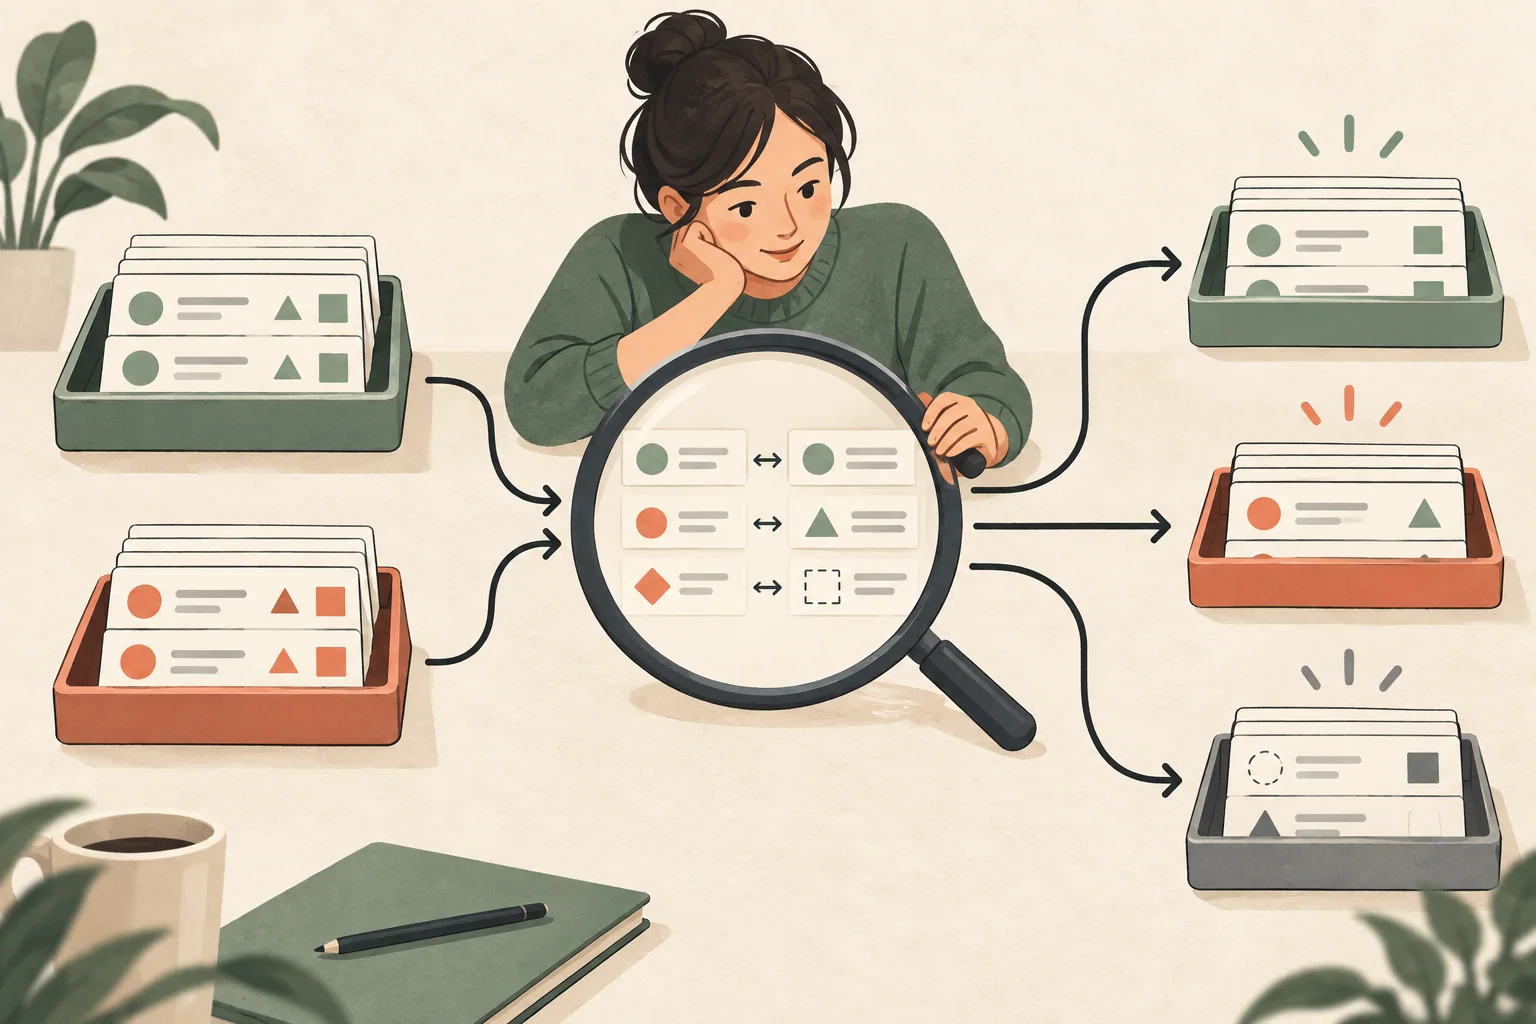
对比两次分类结果,将变化、新增和缺失项分开复核。AI 概念插画。
1. 固定比较对象
Section titled “1. 固定比较对象”两次运行尽量使用同一批记录和输入版本。不能在换模型时同时换抽样范围,然后把全部差异归因到模型。
主键不应随着排序变化。脚本会拒绝重复 ID,避免后一个记录悄悄盖住前一个结果。
2. 运行本地差异检查
Section titled “2. 运行本地差异检查”执行命令,输出一个新文件。默认不覆盖旧结果,不联网,不重新调用模型。
如果结果为空,先检查输入文件是否确实不同,再解释为「这次没有发现标签变化」,不能说「证明完全正确」。
python scripts/compare_runs.py examples/before.csv examples/after.csv --output changes.csv3. 分清改变、缺失和新增
Section titled “3. 分清改变、缺失和新增”随包样本中 ID 2 标签改变,ID 3 在新版缺失,ID 4 为新增。标签改变需要看原文与参考答案;缺失可能只是导出失败;新增说明比较范围发生变化。
这三类结果不能混在一起计算「模型退步」。先修复数据边界,再评估判断质量。
4. 对变化逐条作出接受或退回的决定
Section titled “4. 对变化逐条作出接受或退回的决定”打开对应原文与人工参考,记录变化为什么合理或不合理。对于类别规则本身改变的情况,先更新标注规范,再重新标注受影响案例。
不要为了让新模型表现更好,就只修改新模型做错的参考答案。评估标准的变化也要单独有版本。
5. 保存配置,让下一次比较可重现
Section titled “5. 保存配置,让下一次比较可重现”同时保存问题标准、模型标识、输入范围、时间与测试集版本。Studio 的配置下载只是一个轻量示范;正式部署需要把这些记录跟每个任务关联。
保留一份未用于调参的检查样本。用同一批数据反复改到「全对」,不能证明换一批仍然可靠。
练习可用样本:下载 before.csv(CSV Studio / 本地练习;非本站实测结果)。
本地合成样本应出现 3 条变化记录。报告告诉你发生了什么变化,不替你决定是否上线;正式决策要结合参考标签、失败情况和业务代价。
- 你能说明输入来自哪里、哪些字段会参与处理。
- 你保留了原始记录及不确定、失败和人工修改的结果。
- 你能区分本地练习、作者演示与自己真实调用后的测试。
差异为零可以直接上线吗?
Section titled “差异为零可以直接上线吗?”只能说明这批记录在这个字段上没变。其他指标、错误、调用成本和分布变化仍需检查。