
DuckDB 数据分类前检查:用副本验证 Jev 扩展流程
你得到一份检查过的输入与明确的返回约定。完成标准是记录可逐条核对、失败可见、能够无歧义关联回原表,而不是执行了一个看起来很短的 SQL。
适用场景把 CSV、文档或检索结果整理成可复核的数据
不是让你直接在生产数据库里跑未知代码。先做可回写、可核对、不会丢记录的小测试。先在副本上验证,再谈是否值得接进真实仓库。
来源 · Hamilton Ulmer · X 原帖伴读
2026-09-21 · 编辑整理,未调用真实模型
背景 / 问题
Section titled “背景 / 问题”把数据库里的大表整段复制到聊天框,会丢掉筛选条件、主键和运行环境。Hamilton Ulmer 的案例线索启发我们,把判断放到数据处理附近。但「在 SQL 里写一句」并不意味着背后没有网络请求、权限和费用。
本页先教你准备一个可靠的数据约定。原帖与当前项目应由你通过来源入口检查;在没有核验扩展名称和安装方式前,我们不编造 INSTALL 命令,也不会让页面替你安装。
- 知道主键是什么:它应在筛选、排序与两次运行之间保持稳定。
- 一份已授权的本地 CSV 或非生产数据库导出。
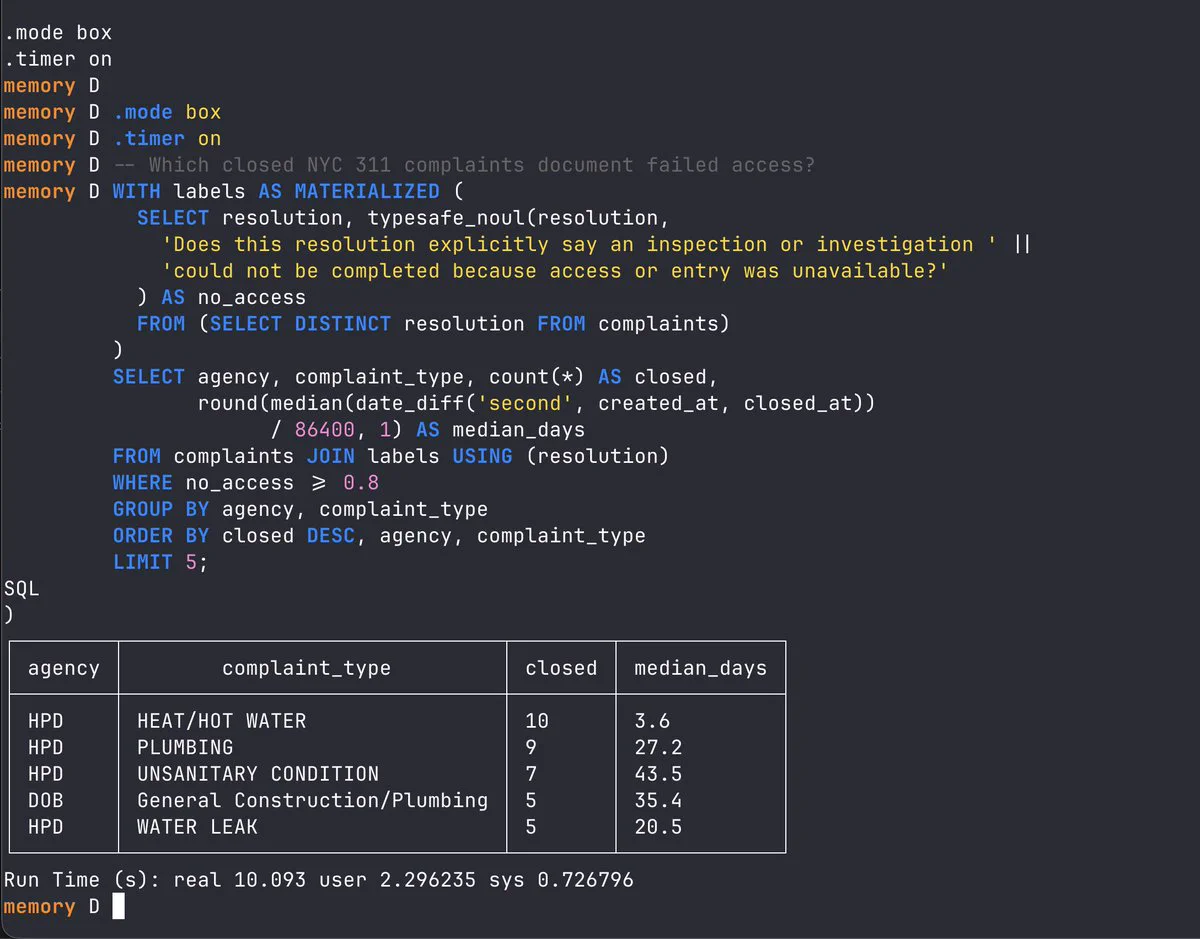
X 原帖配图,作者:Hamilton Ulmer。原帖链接保留;图像来自原作者发布内容,不代表本站实测。
1. 明确扩展在哪一层运行
Section titled “1. 明确扩展在哪一层运行”打开原帖,找到作者实际链接的项目。确认是数据库扩展、Python 包还是演示脚本,它需要哪一版 DuckDB,是否会请求外部服务。
不要从视频看起来像 SQL 就推断数据一定留在本地。扩展可以接触数据库进程能访问的数据,安装前需要单独审查。
2. 只选必要列,并记录查询范围
Section titled “2. 只选必要列,并记录查询范围”先导出稳定 id 与待分类文本,写下筛选条件和行数。不要把生产密码、个人信息、整张订单表或依赖目录一起发出。
如果只测试几十行,明确它们如何抽样。连续前几行可能都属于同一类,不能代表整个数据集。
3. 先让文件检查通过
Section titled “3. 先让文件检查通过”打开 CSV 输入预检器,在浏览器本机选择一份有稳定 id 与文本列的非生产导出。看列名、缺失文本、列错位、重复 ID 和重复内容;工具不会静默删除重复。两名客户发同一句话仍是两个不同事件。
推理层可以在语义条件一致时缓存相同文本,但结果仍要展开回每个原始 ID。
4. 把输出设计成可以 JOIN 回原表
Section titled “4. 把输出设计成可以 JOIN 回原表”至少保存 id、label、review_status、error、模型标识和规则版本。失败或不确定的记录也保留,不通过过滤空结果把它们藏掉。
如果输出只有标签,没有 ID,后面表格重排就可能串行。第一次测试先人工核对几条原文与输出的一一对应。
5. 用完整流程而非单次请求测速度
Section titled “5. 用完整流程而非单次请求测速度”计时包括读表、构造输入、模型请求、重试、写回和必要复核。不要只截取最快的接口响应。
本页配套的是浏览器 CSV 预检器与数据约定,不是 DuckDB 扩展复现。真正接入时,按作者当前文档在隔离环境测试,再考虑生产。
练习样例:下载 reading_list.csv,可在本地练习;非本站实测结果。
你得到一份检查过的输入与明确的返回约定。完成标准是记录可逐条核对、失败可见、能够无歧义关联回原表,而不是执行了一个看起来很短的 SQL。
- 你能说明输入来自哪里、哪些字段会参与处理。
- 你保留了原始记录及不确定、失败和人工修改的结果。
- 你能区分本地练习、作者演示与自己真实调用后的测试。
数据库里调用就不用上传数据了吗?
Section titled “数据库里调用就不用上传数据了吗?”不能这样推断。需要查看实际请求路径和代码,确认哪些字段发送给模型或其他服务。